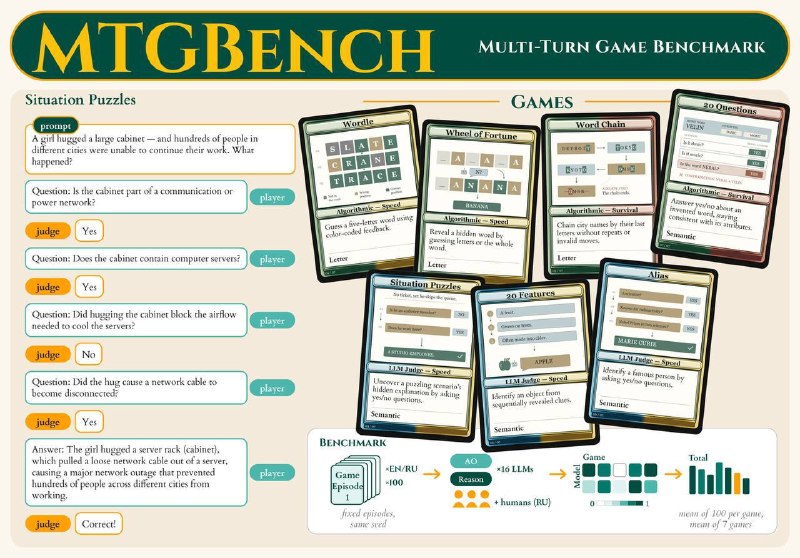
Студенты ШАДа и исследователи Яндекса опубликовали MTGBench — бенчмарк для оценки того, как языковые модели справляются с многошаговыми заданиями. В нём семь игр на русском и английском, включая «Данетки», «Алиас», Wordle и «Поле чудес».
В исследовании рассуждения заметнее улучшали результаты в заданиях с буквами и символами. В задачах на знания и понимание смысла эффект был слабее и зависел от модели.
Статья опубликована в Findings of EMNLP 2026. Код, задания и результаты доступны на GitHub.